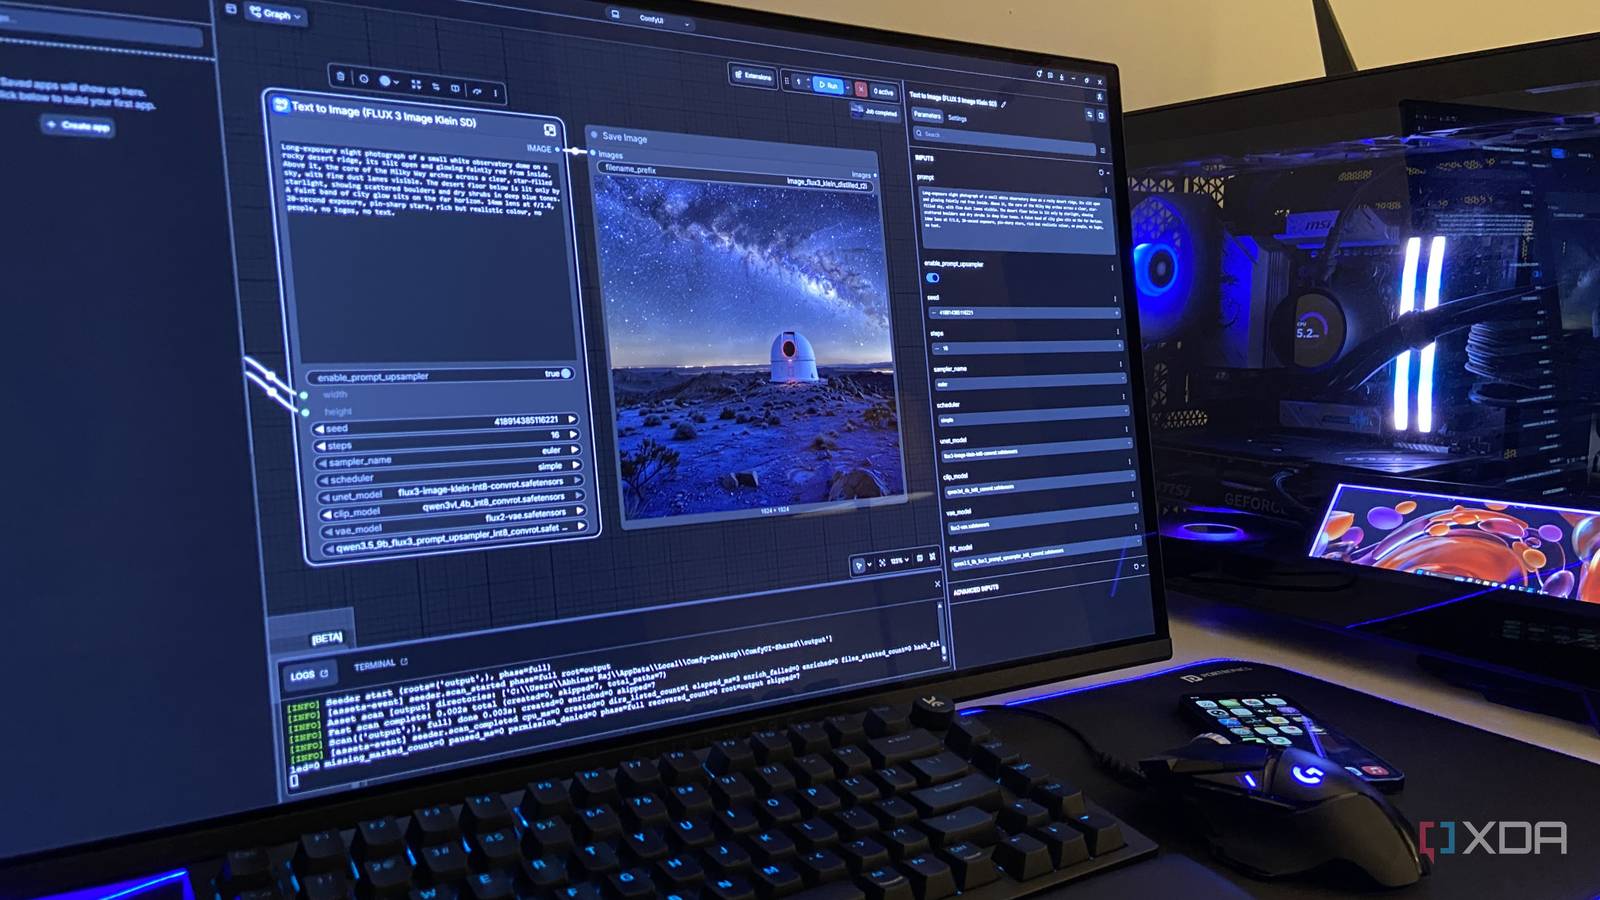
Aprende a configurar um ecossistema de IA local com uma RTX 4070 Ti Super, utilizando múltiplos modelos especializados para pesquisa, código e imagem.
Correr inteligência artificial localmente tem ganhado tração devido às vantagens em termos de privacidade e controlo de custos. Contudo, a limitação de que um único modelo raramente domina tarefas distintas como pesquisa, programação e geração de imagens levou à adoção de uma estratégia de múltiplos modelos especializados.
A estratégia de múltiplos modelos em hardware local
Partindo da experiência partilhada pelo XDA Developers com um computador equipado com uma gráfica Nvidia RTX 4070 Ti Super (16GB VRAM) e um processador AMD Ryzen 5 7600X, a solução passa por dividir o trabalho por três modelos, eliminando subscrições na cloud.
- Pesquisa: O BigBang-v1 (variante do Qwen3.6-35B-A3B) é utilizado para pesquisa profunda. Com a quantização IQ4_XS e o comando
--n-cpu-moe, o modelo descarrega parte dos peritos para a RAM do sistema, permitindo o uso de uma janela de contexto de 128K. A ligação ao motor de busca Exa via MCP permite pesquisas em tempo real. - Programação: O modelo Qwen3.8-27B (quantização UD-IQ4_XS) é a escolha para código, oferecendo um equilíbrio entre qualidade e velocidade de execução, funcionando integralmente na VRAM.
- Imagem: O FLUX 3 Image Klein (versão destilada) é utilizado no ComfyUI, apoiado por um Qwen3.5 (9B) para otimização de prompts e um Qwen3-VL (4B) para codificação. A geração de imagens 1024x1024 demora cerca de 16 segundos.
Considerações técnicas e limitações
Esta configuração demonstra que GPUs de gama média-alta conseguem executar fluxos de trabalho avançados de forma autónoma. Contudo, o utilizador deve considerar que a gestão de memória exige ajustes técnicos avançados, como a utilização de llama.cpp e ComfyUI, cuja curva de aprendizagem pode ser elevada para principiantes. A velocidade de geração é diretamente dependente da VRAM e da RAM disponível, sendo que modelos densos como o Qwen3.8-27B apresentam velocidades de processamento inferiores aos modelos MoE (Mixture of Experts) como o BigBang-v1.
Fontes
Antes de comprares, compara no AHT Scan
Vê preços em várias lojas, promoções e histórico observado num único lugar.
 HPE Alletra MP X10000: Cache offload acelera inferência de IA
 Intel revela GPU D-series com 480GB de memória para IA
 Intel GPU D-Series: O novo acelerador de IA com 1.3 PFLOPS de desempenho