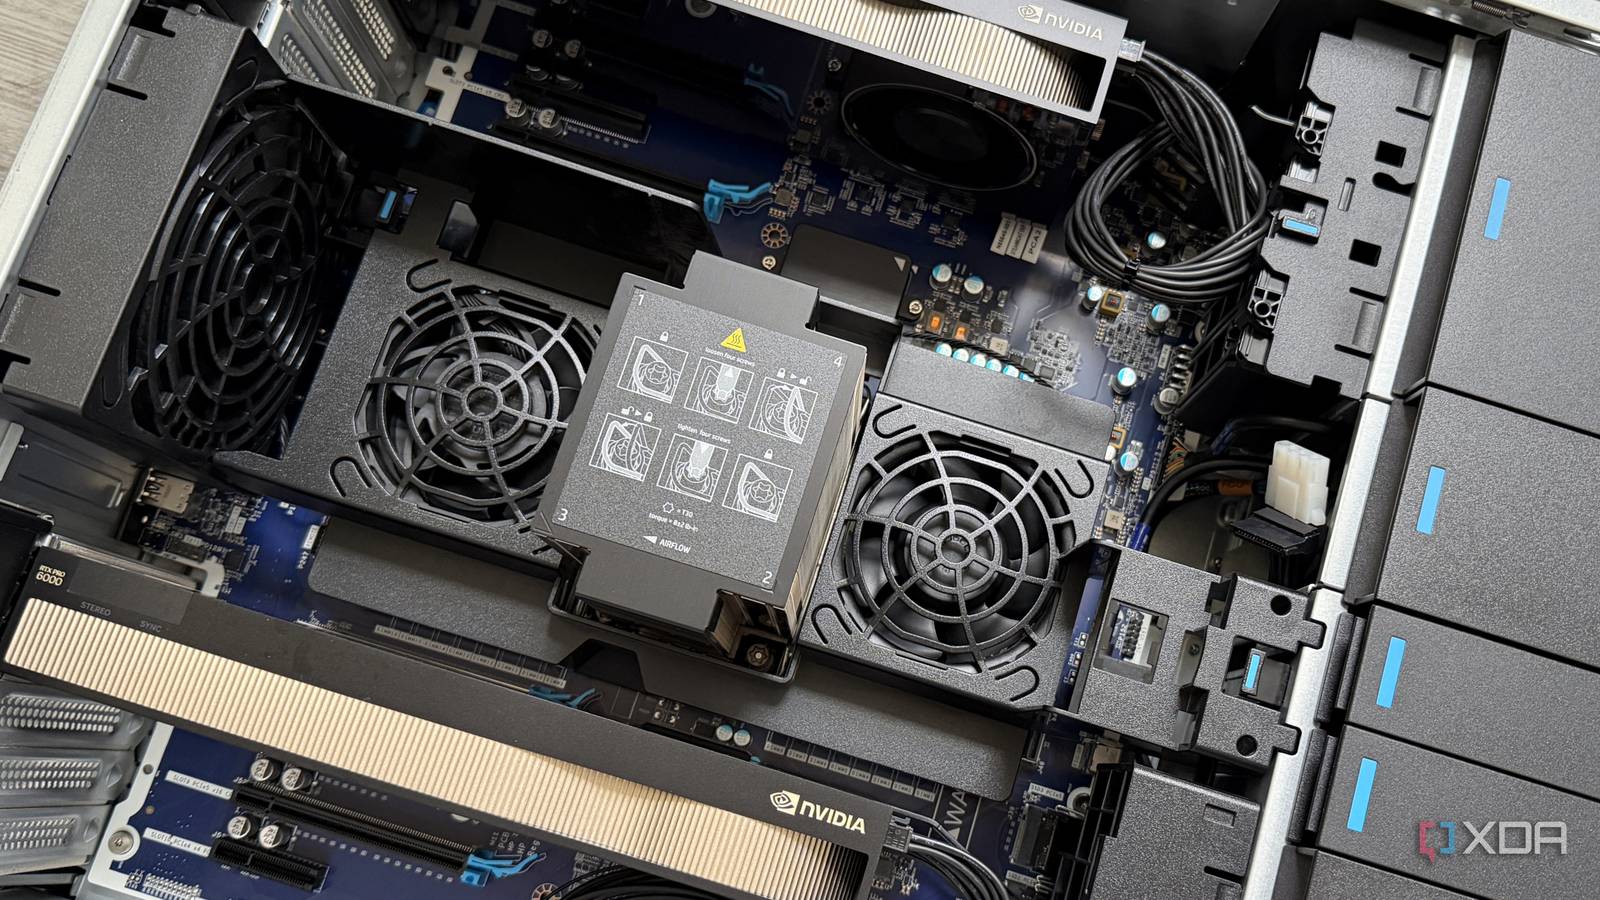
Exploramos como é possível executar o modelo de IA GLM-5.3, com 744 mil milhões de parâmetros, num computador de trabalho com hardware especializado.
O desafio de correr modelos de grande escala localmente
A execução de modelos de linguagem de grande escala (LLM) tem sido, tradicionalmente, uma tarefa reservada a centros de dados devido aos requisitos massivos de memória e poder de processamento. Contudo, a recente disponibilização dos pesos do GLM-5.3, um modelo mixture-of-experts (MoE) com 744 mil milhões de parâmetros, demonstrou que é possível operar tecnologia de ponta num ambiente de trabalho, recorrendo a técnicas de quantização dinâmica.
O modelo GLM-5.3, desenvolvido pela Z.ai, destaca-se por não necessitar de carregar a totalidade dos seus parâmetros para a execução de cada token. Apenas 40 mil milhões de parâmetros estão ativos em qualquer momento, permitindo uma gestão mais eficiente dos recursos, embora o armazenamento total do modelo exija cerca de 1,5 TB de espaço.
Configuração de hardware e otimização
A experiência realizada num computador de trabalho HP Z8 Fury G6i, equipado com duas placas NVIDIA RTX PRO 6000 Blackwell (96GB VRAM cada) e 128GB de RAM, evidenciou que, mesmo com 192GB de VRAM dedicada, a gestão da memória é o fator crítico. Para contornar as limitações físicas, foi utilizada a biblioteca llama.cpp com a configuração --n-cpu-moe, permitindo que parte dos especialistas do modelo residam na memória do sistema (RAM) em vez da memória das placas gráficas.
- Quantização: A utilização de quantização de 2-bits (UD-IQ2_M) permitiu que o modelo mantivesse uma concordância de 78,53% com o modelo original, tornando a execução viável.
- Gestão de Memória: A configuração do WSL2 no Windows 11 foi ajustada para alocar 116GB de RAM, garantindo que o carregamento do modelo não falhasse por falta de memória.
- Desempenho: Em testes práticos, o sistema atingiu velocidades entre 12,0 e 12,2 tokens por segundo, superando a velocidade de leitura humana, embora o processamento de prompts longos (acima de 32K tokens) apresente latências significativas devido à dependência da RAM do sistema.
Implicações e limitações
Embora este feito demonstre a viabilidade técnica de correr modelos de "fronteira" em hardware local, a experiência sublinha que esta não é uma solução de consumo imediato. O custo do hardware utilizado, estimado em cerca de 65.000 dólares, coloca esta configuração fora do alcance do utilizador doméstico comum. Além disso, a eficiência em tarefas de raciocínio complexo, como a geração de código, mostrou que o modelo pode atingir limites de tokens ou tempos de espera elevados, dependendo da complexidade da tarefa solicitada.
Este avanço é um marco importante para a investigação em IA local, provando que a barreira entre o que é possível executar em centros de dados e o que pode ser processado localmente continua a diminuir, graças a otimizações de software como as da Unsloth e do projeto llama.cpp.
Fontes
Antes de comprares, compara no AHT Scan
Vê preços em várias lojas, promoções e histórico observado num único lugar.
 AMD Instinct MI450X: nova GPU reforça flexibilidade na série MI400
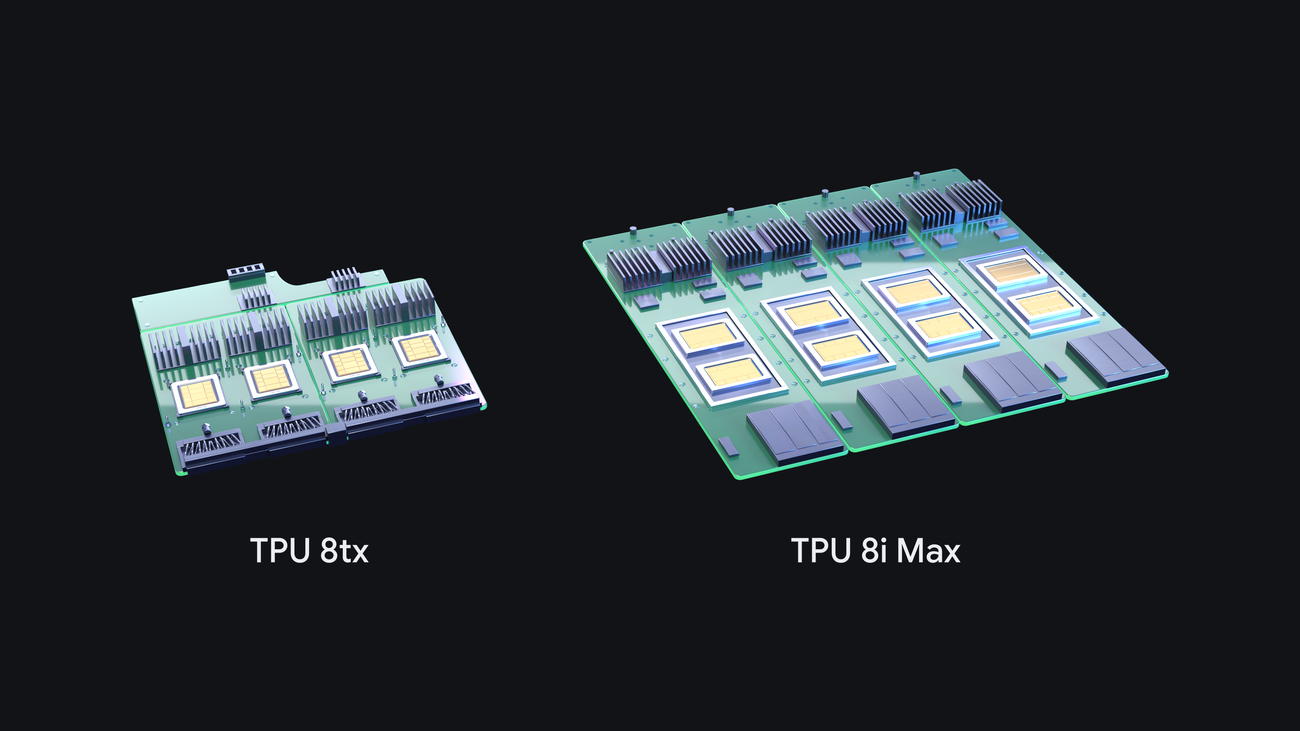 Google expande infraestrutura de IA com novas TPUs focadas em segurança e contexto
 Black Friday: AHT Scan encontra diferenças até 84 € nos preços