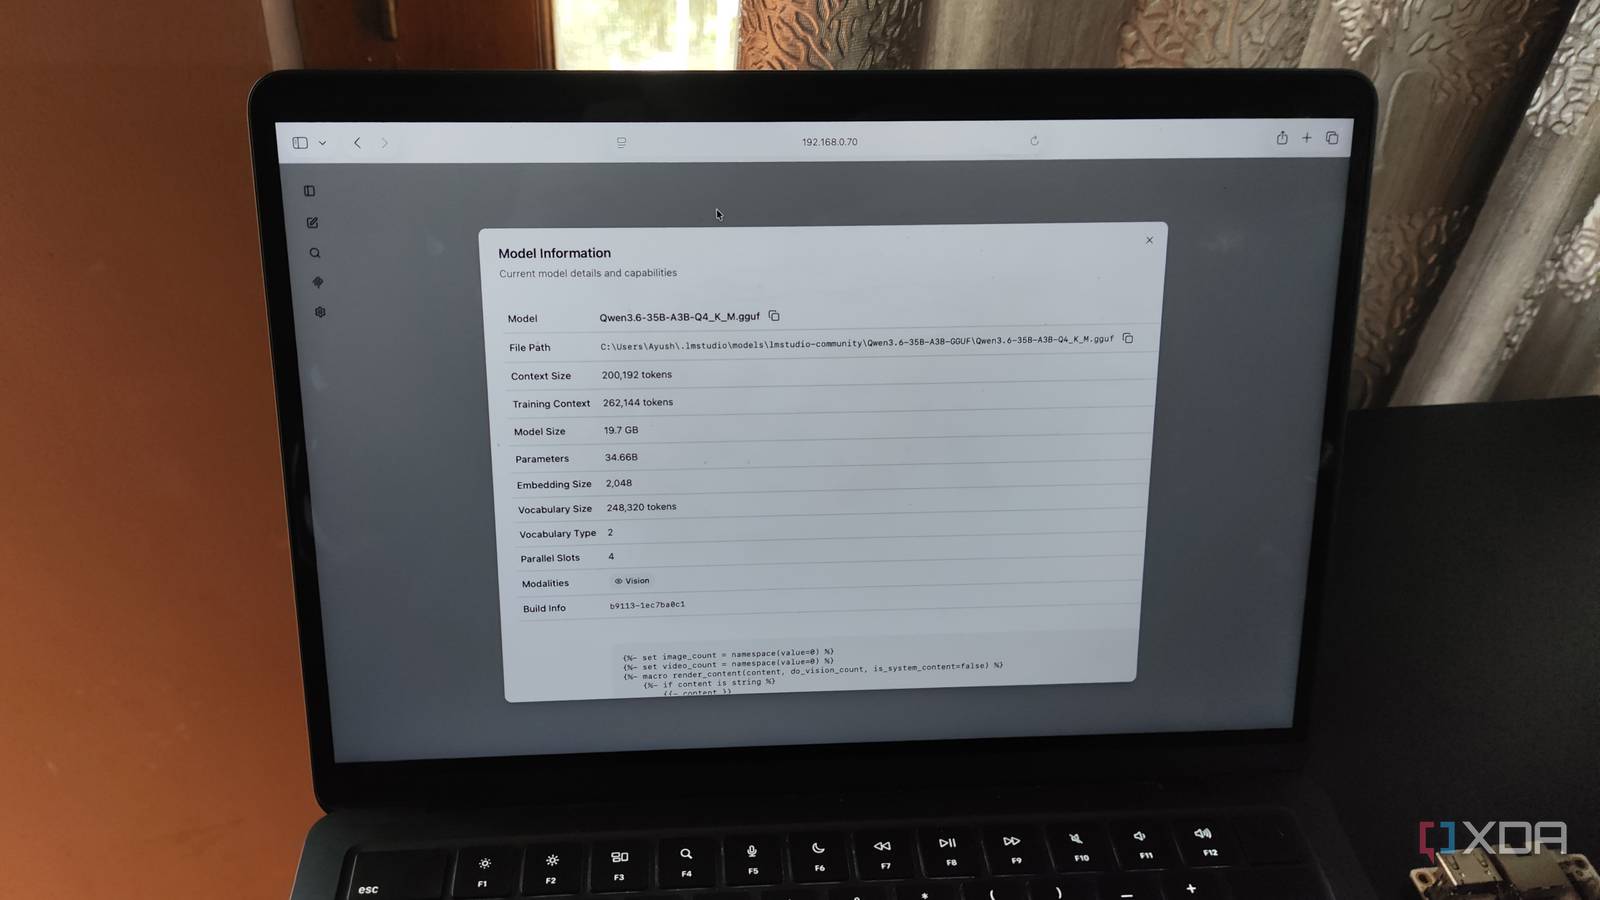
Descobre como a arquitetura Mixture-of-Experts (MoE) permite utilizar modelos de linguagem de grande dimensão em placas gráficas com pouca VRAM.
A mudança de paradigma na execução local de LLMs
A execução local de Large Language Models (LLMs) tem sido historicamente limitada pela quantidade de VRAM disponível nas placas gráficas. Tradicionalmente, modelos com arquitetura densa exigem que todos os seus parâmetros estejam carregados na memória de vídeo para processar cada token, o que torna modelos de grande dimensão proibitivos para hardware mais antigo ou com menos memória. Contudo, a ascensão dos modelos Mixture-of-Experts (MoE) está a alterar esta realidade.
Ao contrário dos modelos densos, onde cada parâmetro participa na inferência, os modelos MoE utilizam uma estrutura de "especialistas". Um mecanismo de encaminhamento (routing) atribui cada token a um subconjunto específico de redes paralelas, mantendo o restante do modelo inativo. Esta eficiência permite que apenas uma parte do modelo resida na VRAM, enquanto o restante pode ser alocado na memória do sistema (RAM).
Vantagens para hardware limitado
Para utilizadores com GPUs mais antigas, esta arquitetura oferece uma nova vida útil. Segundo relatos técnicos, é possível manter os pesos de atenção, embeddings e os especialistas ativos na VRAM da placa gráfica, enquanto as camadas de especialistas menos utilizadas permanecem na RAM do computador. Esta técnica permite:
- Executar modelos com dezenas de milhares de milhões de parâmetros em GPUs com apenas 8GB a 12GB de VRAM.
- Manter taxas de geração de tokens aceitáveis, evitando o estrangulamento severo que ocorreria ao tentar forçar modelos densos através do barramento PCIe.
- Aproveitar hardware de gerações anteriores, como a série GTX 10 ou RTX 30, para tarefas de produtividade que antes exigiriam hardware de topo.
É importante notar que, embora a RAM do sistema possa compensar a falta de VRAM, a configuração requer uma gestão cuidadosa dos parâmetros e a utilização de frameworks como o llama.cpp para otimizar o carregamento das camadas. A eficácia desta abordagem depende diretamente da capacidade do utilizador em configurar o ambiente de execução para equilibrar a carga entre o GPU e o CPU.
Implicações para o utilizador
Para quem utiliza ferramentas de IA localmente, como substitutos do GitHub Copilot ou assistentes de troubleshooting, esta evolução significa que o custo de entrada para correr modelos de alta capacidade baixou significativamente. A necessidade de investir em hardware de última geração com VRAM massiva deixa de ser o único caminho para obter resultados de qualidade em tarefas de produtividade pessoal.
Fontes
Antes de comprares, compara no AHT Scan
Vê preços em várias lojas, promoções e histórico observado num único lugar.
 Como atualizar o firmware dos seus AirPods: o guia prático
 AssistiveTouch no Apple Watch: Como controlar o relógio com gestos
 Como limpar a cache do Android para libertar espaço e melhorar o desempenho