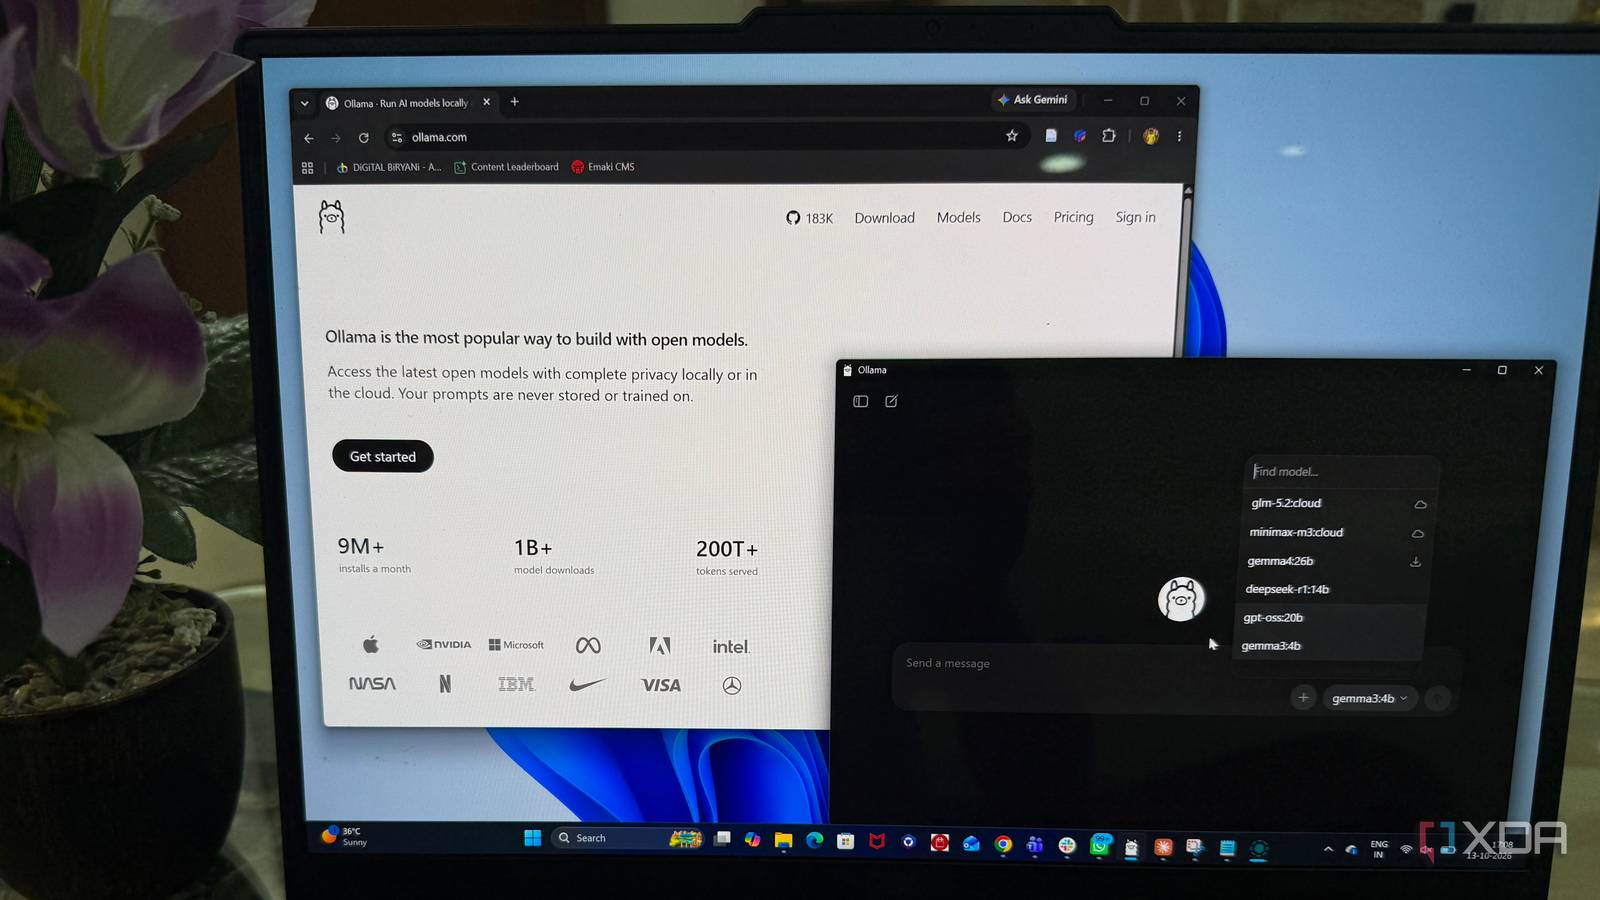
O Ollama simplifica a IA local, mas o llama.cpp oferece maior controlo. Compara as diferenças de performance, configuração e flexibilidade para o teu setup.
A evolução da IA local: Do Ollama ao controlo total
Correr modelos de linguagem (LLMs) localmente no teu computador tornou-se significativamente mais acessível nos últimos meses. Ferramentas como o Ollama permitiram que utilizadores sem conhecimentos avançados de engenharia de software pudessem descarregar e interagir com modelos de IA através de uma interface simples no terminal. Contudo, à medida que as necessidades de utilização crescem, a questão sobre qual a melhor ferramenta para gerir estes modelos torna-se pertinente.
O Ollama destaca-se pela sua facilidade de utilização. Funciona como um serviço em segundo plano que expõe uma API, permitindo que outras aplicações se liguem a modelos locais sem configurações complexas. É, sem dúvida, a recomendação principal para quem quer começar a explorar a IA offline sem lidar com a gestão manual de dependências ou parâmetros de inferência.
Quando considerar a transição para o llama.cpp
Apesar da conveniência, o Ollama impõe certas limitações que podem afetar utilizadores avançados. Um dos pontos críticos é a gestão da janela de contexto, frequentemente limitada a 4.096 tokens por defeito, o que pode restringir a análise de documentos longos. Além disso, a estrutura de armazenamento de modelos do Ollama, que utiliza ficheiros com hashes, dificulta a utilização direta desses mesmos modelos noutros motores de inferência.
É aqui que o llama.cpp se posiciona como uma alternativa robusta. Ao trabalhar mais próximo do motor de inferência, o utilizador ganha a capacidade de ajustar:
- Contexto: Definição precisa do tamanho da janela de memória.
- GPU Offloading: Controlo sobre a carga de processamento entre CPU e GPU.
- Parâmetros de amostragem: Ajustes finos para o comportamento do modelo.
Embora o llama.cpp exija uma curva de aprendizagem mais acentuada e uma configuração manual mais rigorosa, a sua flexibilidade permite otimizar a performance em hardware específico, algo que a camada de abstração do Ollama pode limitar.
O que deves saber antes de escolher
Se estás a começar agora, o Ollama continua a ser a escolha recomendada. A capacidade de descarregar e testar diferentes modelos com um simples comando é inigualável para quem quer apenas ver o potencial da tecnologia. No entanto, se sentes que o teu setup atual está a limitar a tua produtividade ou se precisas de integrar modelos em fluxos de trabalho mais complexos, explorar o llama.cpp pode oferecer o controlo necessário.
Para quem já utiliza IA local, é importante recordar que a escolha do motor de inferência não significa abdicar de interfaces amigáveis. O llama.cpp oferece um servidor compatível com a API da OpenAI, o que significa que podes continuar a usar muitas das aplicações que já conheces, beneficiando apenas de um backend mais flexível e transparente.
Para mais contexto sobre a utilização de IA no teu dia a dia, consulta o nosso artigo sobre a experiência de substituir ferramentas na nuvem por modelos locais.
Fontes
Antes de comprares, compara no AHT Scan
Vê preços em várias lojas, promoções e histórico observado num único lugar.
 AMD Instinct MI450X: nova GPU reforça flexibilidade na série MI400
 Google expande infraestrutura de IA com novas TPUs focadas em segurança e contexto
 Black Friday: AHT Scan encontra diferenças até 84 € nos preços