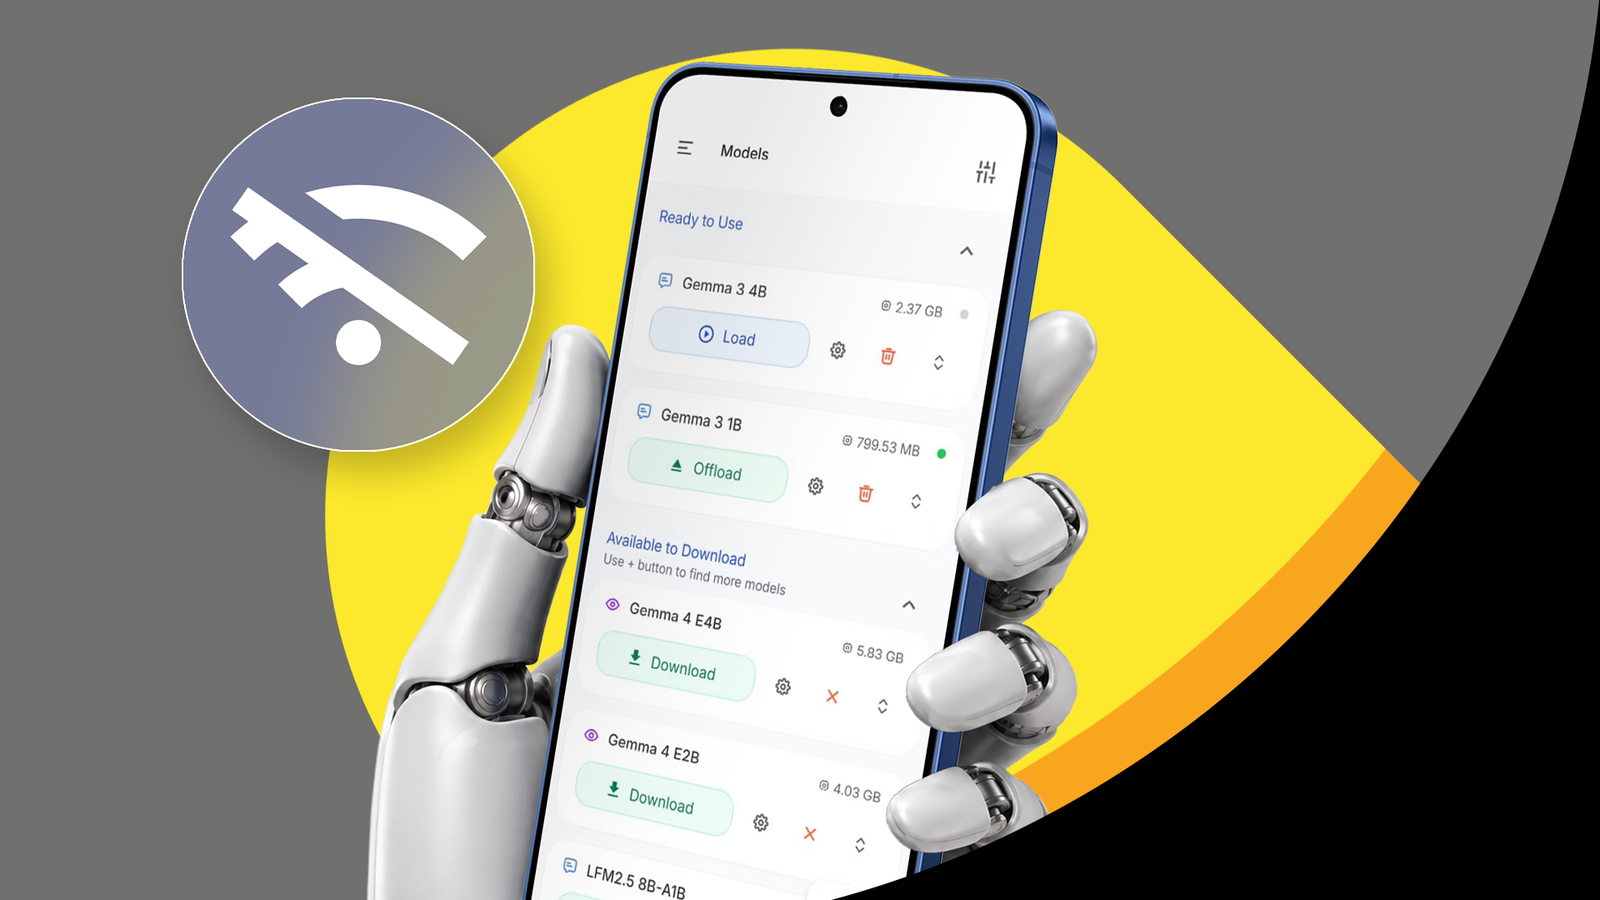
Descobre como usar a aplicação PocketPal AI para executar modelos de linguagem como Gemma ou Phi localmente no teu telemóvel, garantindo privacidade e uso offline.
Privacidade e autonomia com modelos de IA locais
A execução de modelos de linguagem (LLM) diretamente no telemóvel tem ganho tração como uma alternativa à dependência constante da nuvem. A aplicação PocketPal AI destaca-se por permitir que utilizadores de Android corram modelos como Gemma, Qwen ou Phi sem necessidade de ligação à internet, mantendo todas as conversas e processamento confinados ao hardware do dispositivo.
O que precisas para começar
Ao contrário de uma aplicação convencional, correr um modelo de IA localmente exige recursos de hardware significativos. A aplicação utiliza o motor llama.cpp para tirar partido do CPU, GPU ou NPU do teu telemóvel. Para uma experiência funcional, a recomendação técnica é:
- Memória RAM: Pelo menos 6GB para modelos mais pequenos e 8GB ou superior para modelos de maior dimensão.
- Armazenamento: Espaço livre suficiente para descarregar os ficheiros GGUF dos modelos.
- Hardware: Telemóveis mais recentes com processadores otimizados oferecem um desempenho de inferência superior.
Como configurar o PocketPal AI
A instalação é feita através da Google Play Store, sendo uma solução de código aberto disponível no GitHub. Após a instalação, o processo é simples:
- Download do Modelo: No ecrã inicial, seleciona "Download Model". Podes consultar o tamanho, contagem de parâmetros e capacidades de cada opção.
- Carregamento: Após o download, toca em "Load" para carregar o modelo na memória.
- Gestão: Através do menu lateral, podes adicionar novos modelos via Hugging Face ou ficheiros locais.
Limitações e trade-offs
Embora a privacidade seja a grande vantagem — uma vez que os teus dados não saem do telemóvel — existem compromissos claros face a serviços como o Gemini ou ChatGPT. A velocidade de resposta é notavelmente inferior e, por estar totalmente offline, a IA não consegue aceder a informações em tempo real, como notícias do dia ou eventos atuais. Além disso, modelos mais pequenos possuem capacidades de raciocínio mais limitadas do que os grandes modelos baseados na nuvem.
Esta solução é ideal para quem procura um assistente privado, funcional em modo avião ou em locais com má rede, e que valoriza o controlo total sobre o modelo que está a utilizar.
Fontes
Antes de comprares, compara no AHT Scan
Vê preços em várias lojas, promoções e histórico observado num único lugar.
 CameraX: como a Google estabiliza a verificação de identidade no Android
 Google estabiliza ferramentas de desenvolvimento para Android XR
 Android evolui para sistema centrado em agentes de IA: O que muda para os programadores