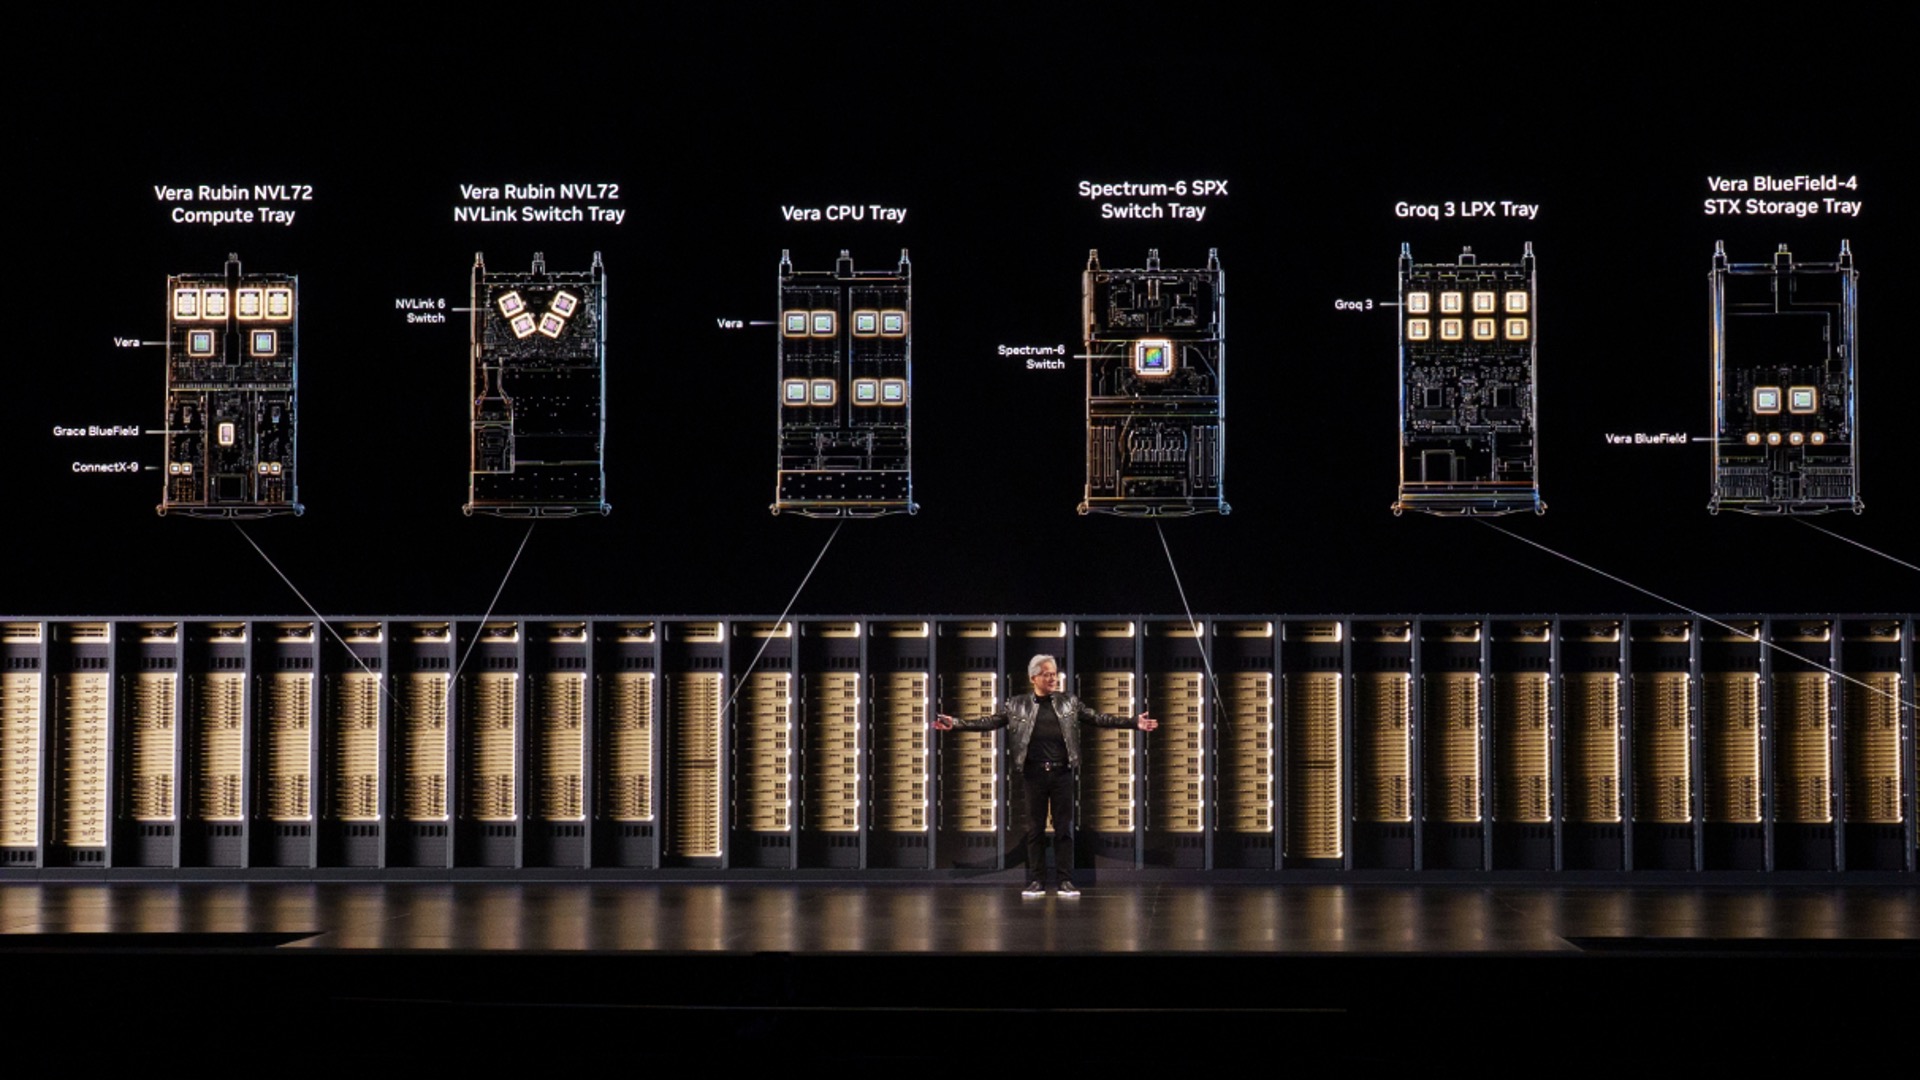
A NVIDIA compara Rubin e Blackwell numa carga de IA. Explicamos o papel da memória HBM e o que o ganho de até 30 vezes por dólar permite concluir.
A NVIDIA publicou uma comparação que ajuda a separar dois números que parecem contar a mesma história: a capacidade de memória e o custo de servir um modelo de IA. No teste que a empresa apresenta, o Vera Rubin NVL72 consegue até 30 vezes mais rendimento por dólar do que o GB300 NVL72 a 125 tokens por segundo por utilizador, embora a capacidade de memória HBM por GPU suba cerca de 3%. É um resultado para uma carga específica, não uma melhoria garantida para qualquer modelo.
O que entra na memória da GPU
A memória HBM é a mais rápida do sistema. Durante a inferência, aloja os pesos do modelo e também pode guardar a cache KV, que permite reaproveitar parte do cálculo feito sobre o contexto de uma conversa ou de um pedido. Quando há muitos pedidos em simultâneo, esses dois usos disputam espaço. Segundo a NVIDIA, usar uma representação mais compacta para os pesos e para a cache liberta memória para servir mais pedidos.
A empresa descreve ainda duas alternativas para guardar o contexto que não está a ser usado naquele instante: a memória LPDDR do processador Vera e o armazenamento partilhado CMX, gerido pelo software NVIDIA Dynamo. A ideia é usar a HBM para o trabalho que precisa de resposta imediata e voltar a carregar o contexto antes de ser necessário.
O que se deve comparar antes de escolher um sistema
A NVIDIA usa a carga AgentX DeepSeek V4 Pro para ilustrar o resultado. O valor de 125 tokens por segundo refere-se à velocidade por utilizador naquele ponto da comparação. Já o ganho de até 30 vezes refere-se ao trabalho entregue por dólar. Portanto, um operador que esteja a comparar propostas deve pedir medições com o mesmo modelo, o mesmo tamanho de contexto e a mesma velocidade por utilizador, e verificar o que acontece ao custo quando aumenta o número de pedidos em simultâneo.
Também convém pedir que o fornecedor indique onde ficou a cache durante o teste. Duas configurações com capacidade HBM semelhante podem ter resultados diferentes se uma conseguir manter mais contexto na memória rápida ou recuperar mais depressa o contexto que foi movido. O artigo técnico da NVIDIA descreve o mecanismo e o teste, mas não apresenta um preço de compra para Portugal.
Fonte
NVIDIA: como a arquitetura tira mais partido da memória durante a inferência
Antes de comprares, compara no AHT Scan
Vê preços em várias lojas, promoções e histórico observado num único lugar.
 AMD Instinct MI450X: nova GPU reforça flexibilidade na série MI400
 NVIDIA revela novas normas abertas para infraestruturas de IA no OCP Global Summit
 Microsoft revela Maia 2026: A nova arquitetura de IA para centros de dados