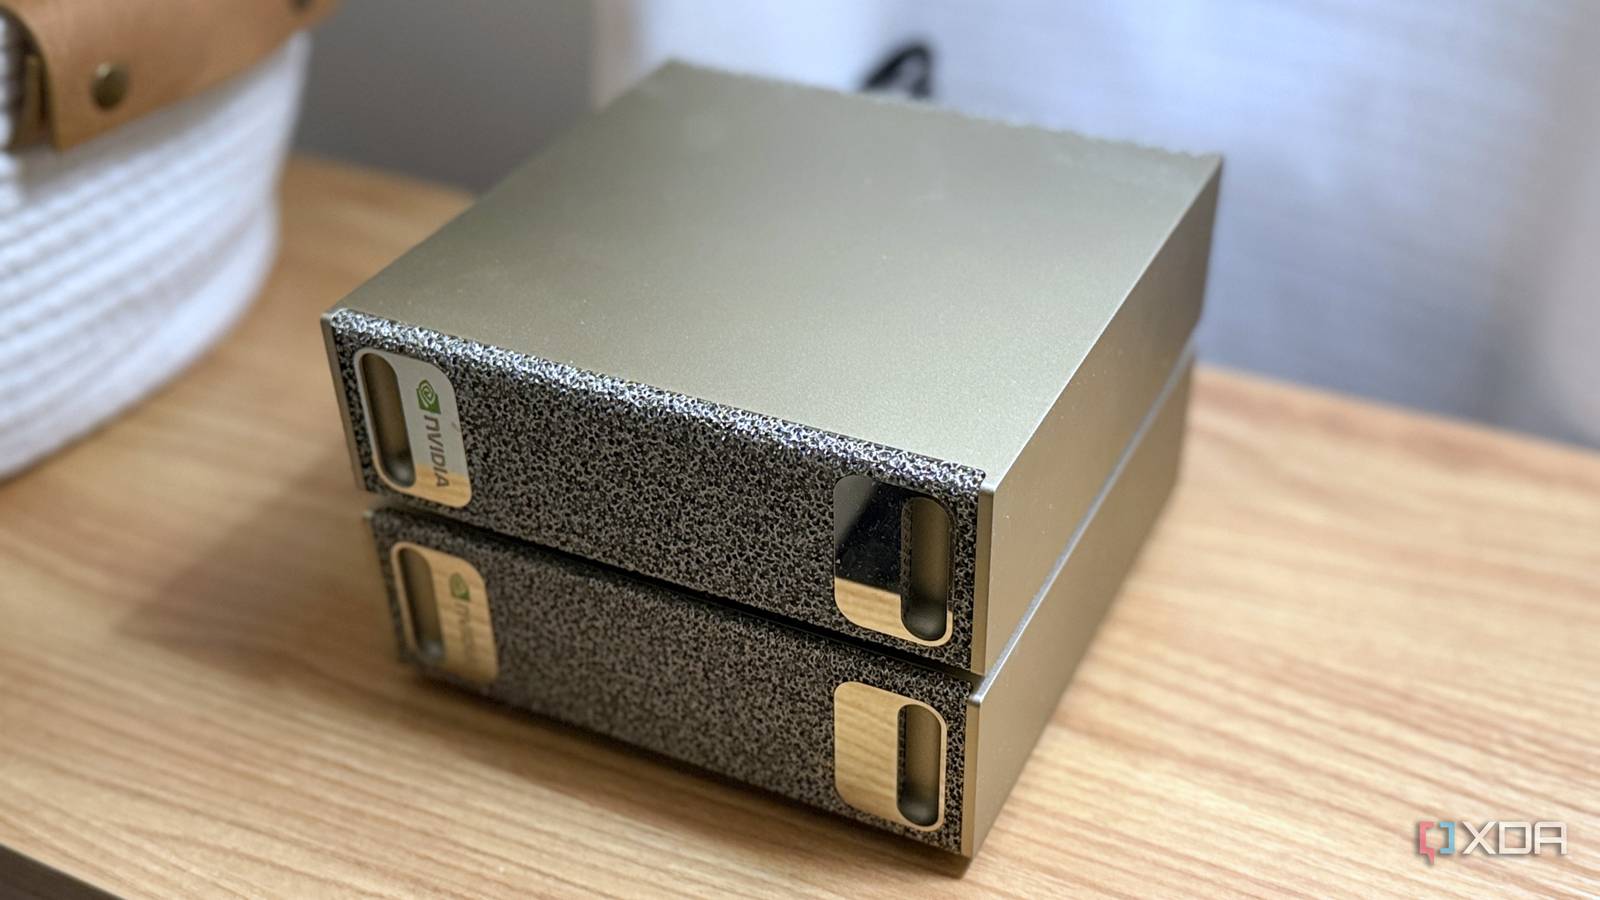
Exploramos os desafios reais de treinar um modelo de IA localmente com a Nvidia DGX Spark, analisando gargalos, eficiência de hardware e otimização de software.
Para além do poder bruto: O treino de modelos de IA
Treinar um modelo de linguagem (LLM) de raiz é um desafio que vai muito além da simples capacidade de processamento. A experiência com a Nvidia DGX Spark, uma unidade de computação compacta equipada com o Grace Superchip e núcleos de GPU Blackwell, demonstra que a eficiência no treino de IA depende tanto da otimização de software como do hardware.
Ao tentar treinar um modelo estilo ChatGPT, a utilização da GPU pode ser enganadora. É possível observar uma utilização de 96% no painel de controlo, enquanto o chip opera a uma fração da sua capacidade real. Este fenómeno ocorre porque a métrica de utilização mede a frequência com que um núcleo executa uma tarefa, e não a intensidade do processamento em si.
Os gargalos invisíveis no treino local
Um dos maiores desafios encontrados foi a gestão de múltiplos sistemas. Ao emparelhar duas unidades DGX Spark, o sistema fica limitado pela velocidade do componente mais lento. Cada atualização de parâmetros exige que as máquinas sincronizem dados, criando tempos de espera significativos se um dos nós apresentar inconsistências de desempenho.
- Software e Atenção: A escolha do caminho de atenção (como o FlashAttention) é crítica. Falhas na implementação podem degradar drasticamente a velocidade, tornando o treino ineficiente.
- Gestão de Energia: Problemas no controlador de entrega de energia (USB-C) podem limitar o clock da GPU sem disparar alertas de erro, um problema comum que exige intervenção física, como um ciclo de energia completo.
- Largura de banda: Embora a memória de 128GB seja generosa, a largura de banda de dados pode tornar-se um estrangulamento em comparação com sistemas de escala industrial como os equipados com H100.
Para quem pretende explorar o treino local de LLMs, a lição principal é a importância de realizar testes de curta duração antes de comprometer dias de processamento. Otimizar o caminho de atenção e validar a estabilidade dos clocks em todos os nós são passos essenciais para evitar desperdício de tempo e energia.
Esta análise sobre a infraestrutura de IA complementa discussões mais amplas sobre a soberania e a gestão de dados, como as que têm sido debatidas em eventos sobre infraestrutura de IA, onde a eficiência do hardware é um pilar fundamental para o desenvolvimento sustentável de modelos locais.
Fontes
Antes de comprares, compara no AHT Scan
Vê preços em várias lojas, promoções e histórico observado num único lugar.
 AMD Instinct MI450X: nova GPU reforça flexibilidade na série MI400
 Google expande infraestrutura de IA com novas TPUs focadas em segurança e contexto
 Black Friday: AHT Scan encontra diferenças até 84 € nos preços